
Albo: jak szukając pradziadków, zostałem kierownikiem fabryki, w której pracują roboty, a ja przynoszę kawę.
Jak to się zaczęło
Każdy z nas zaczynał tak samo. Babcia przy stole, stare zdjęcie bez podpisu, pytanie „a skąd my właściwie jesteśmy?”. Potem pierwsza wizyta w archiwum, pierwsza metryka chrztu odczytana z wypiekami na twarzy i pierwszy zapis „ojciec nieznany”, który psuje humor na cały tydzień.
Metryki parafialne to chleb powszedni genealoga. Pokazują, kto się urodził, z kim się ożenił i kiedy umarł. Ale na Kresach, a zwłaszcza na Podolu i Kijowszczyźnie, księgi metrykalne często nie sięgają dalej niż do XVIII wieku. A tam, gdzie się kończą, zaczyna się prawdziwa przygoda: księgi sądowe.
Księgi grodzkie i ziemskie to coś w rodzaju dawnego urzędu, notariusza i sądu w jednym. Szlachcic sprzedawał wieś – wpisywał to do grodu. Ojciec przekazywał majątek synowi – wpis. Sąsiad najechał sąsiada i porąbał mu sługę – wpis, a do tego obdukcja rannego. Testamenty, intercyzy ślubne, kwity, pełnomocnictwa, długi, procesy o miedzę. W jednej takiej księdze potrafi się przewinąć kilka tysięcy nazwisk, z miejscowościami, urzędami i koligacjami.
Dla genealoga to skarb. Problem w tym, że ten skarb jest zamknięty na kłódkę, a do kłódki nie ma klucza. Albo inaczej: klucz jest, ale waży kilka ton.
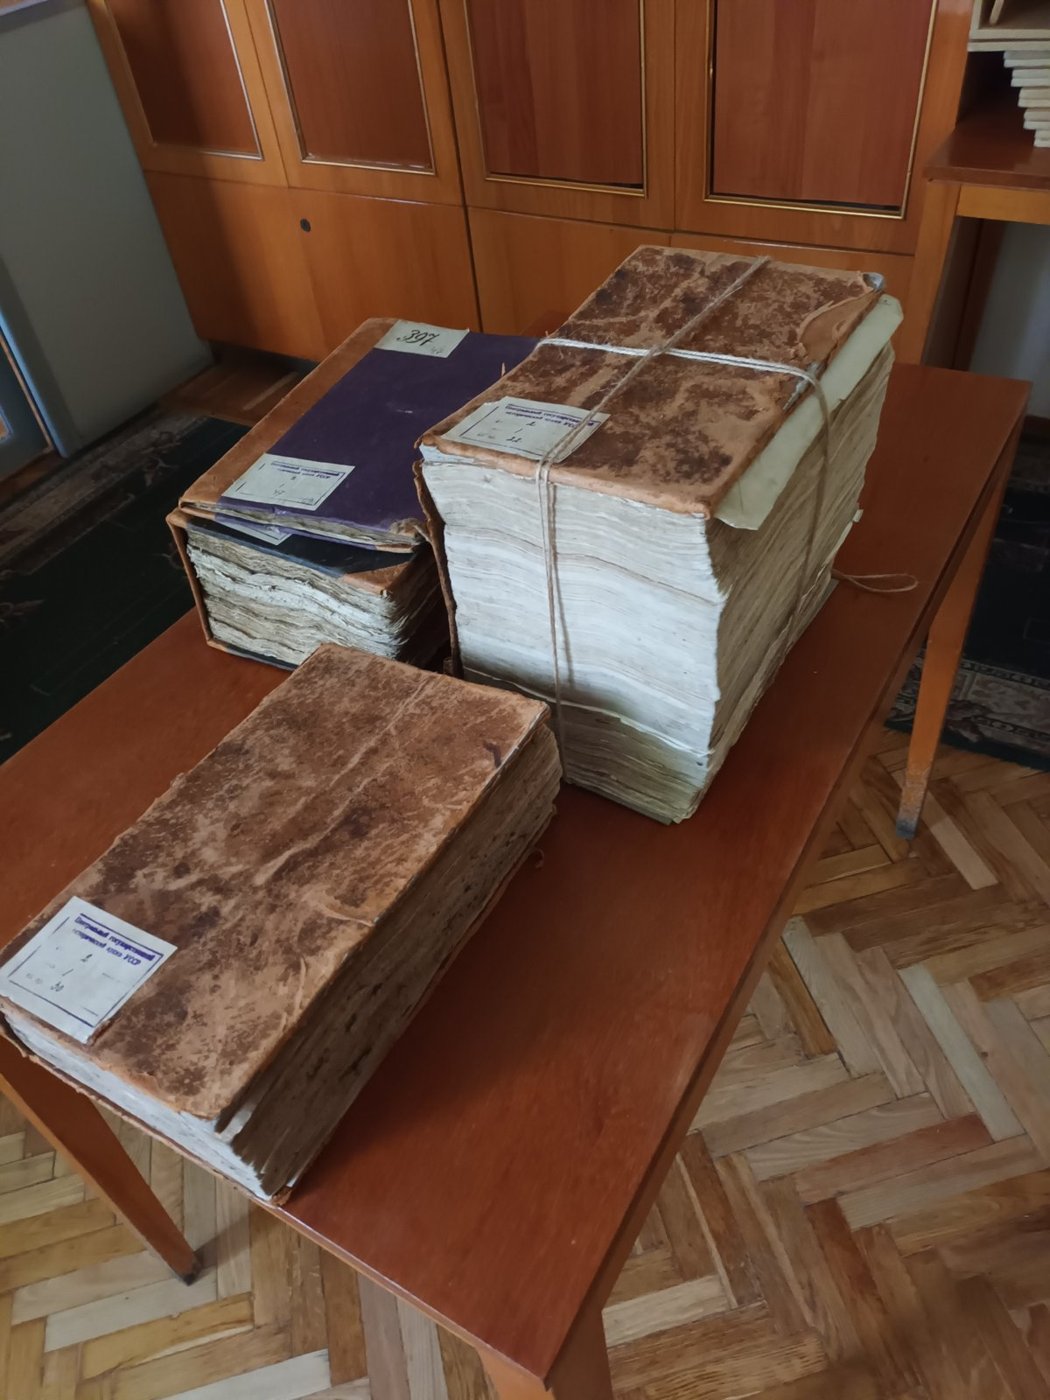
Klucz, który waży kilka ton. Księgi grodzkie w CDIAK w Kijowie, lato 2022.
Góra papieru
Zobaczmy, z czym się mierzymy. Księgi, nad którymi pracuję, leżą w Centralnym Państwowym Archiwum Historycznym Ukrainy w Kijowie (CDIAK). Na szczęście są zeskanowane – a wiem to najlepiej, bo skanowałem je sam. Na nieszczęście – tylko zeskanowane.
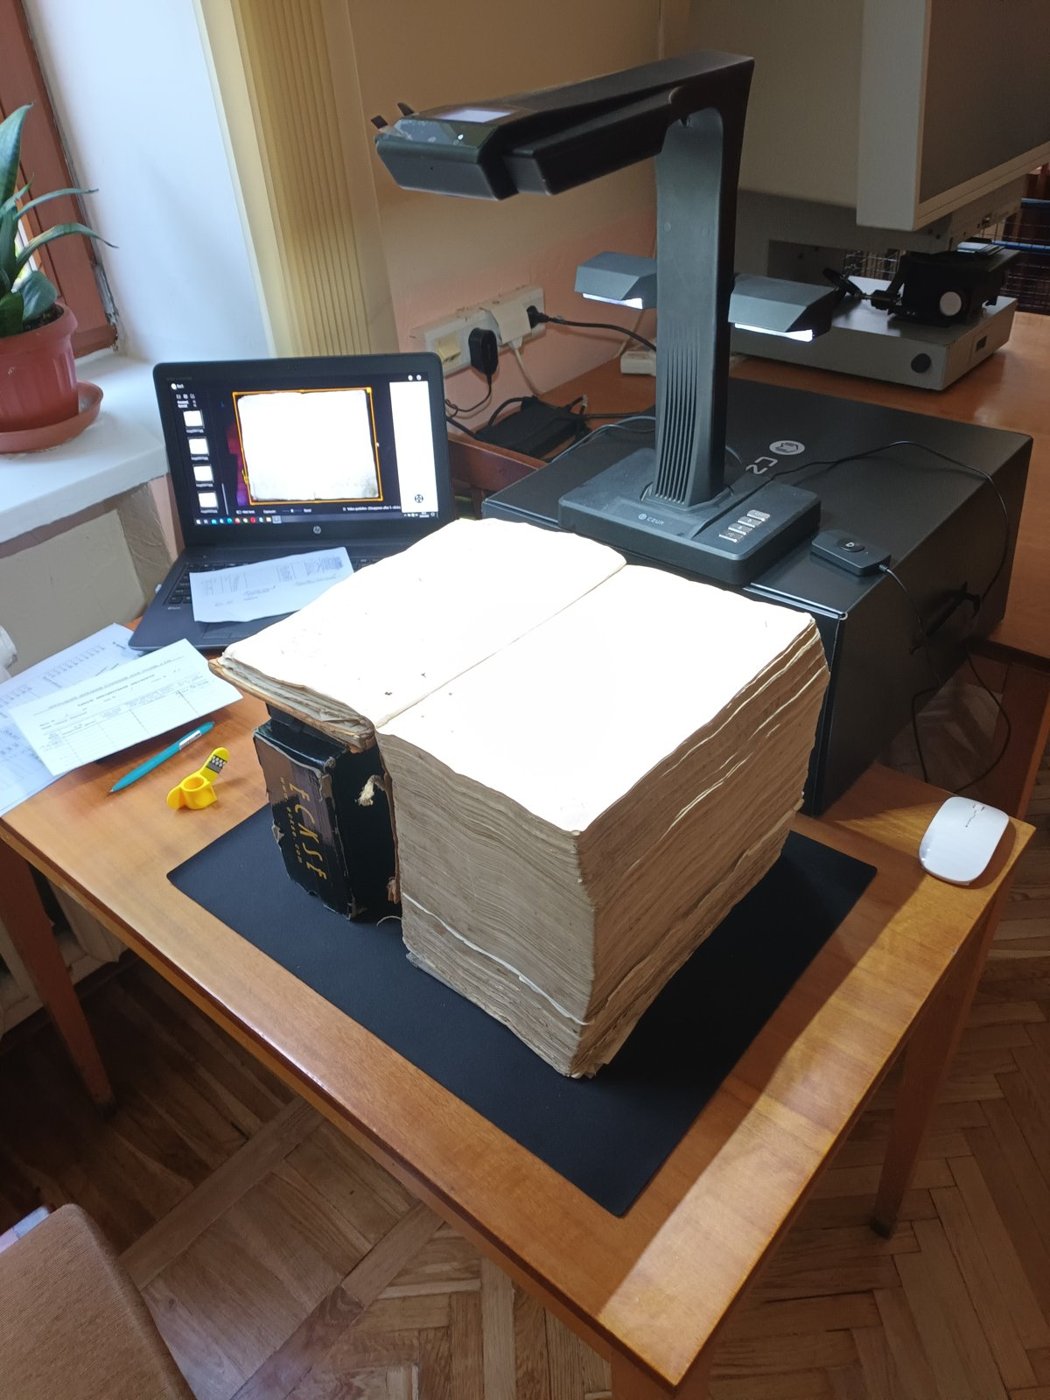
Moje stanowisko pracy w CDIAK, 2022: księga pod skanerem, strona po stronie.
Siedem miesięcy w Kijowie
„Skanowałem je sam” brzmi niewinnie, więc dopowiem, jak to wyglądało. Projekt skanowania ksiąg w CDIAK trwał około siedmiu miesięcy, od maja do końca listopada 2022 roku.
Do Kijowa wróciłem w maju, gdy tylko Rosjanie odeszli spod miasta. Na autostradzie Żytomierz–Kijów stały jeszcze rozbite czołgi, a w Kijowie na każdej ulicy był blokpost. Miasto było wyludnione. Przed wojną dojazd z domu do archiwum zajmował mi od trzech kwadransów do półtorej godziny. W maju 2022 – piętnaście minut.
Siedziałem w czytelni sam, samiusieńki, z księgą pod skanerem. A za oknem trwała wojna. Wyły syreny alarmów przeciwlotniczych, wyłączano prąd. Skaner bez prądu jest tylko bardzo drogim stojakiem na książkę.
Co trzy tygodnie wracałem na tydzień do Polski – na chemioterapię, bo choruję na raka. Potem znowu Kijów i znowu skaner. W październiku i listopadzie zrobiło się tam bardzo zimno, a archiwum nie było ogrzewane. Siedziałem w grubej kurtce i w rękawiczkach, i skanowałem, skanowałem.
Z tamtych tygodni zostały tysiące zdjęć stron, które czekały na kogoś, kto je przeczyta. Ten artykuł jest w gruncie rzeczy o tym, jak w końcu doczekały się czytelnika.
Ile tego jest
Jedna księga to kilkaset dużych zdjęć, każde przedstawia rozkładówkę, czyli dwie strony. Pojedynczy skan księgi kijowskiej ma 6500 na 4900 pikseli i waży około 6 MB. Przykłady:
- Księga grodzka winnicka 44-1-5 (1769–1770): 617 skanów, 987 aktów. Po przepisaniu i opracowaniu – plik liczy 2513 stron.
- Księga grodzka kijowska 2-1-1: 750 skanów, 870 aktów, 2144 strony opracowania.
- Księga 2-1-2 (Żytomierz i Owrucz, 1733–1735): 1884 strony rękopisu.
- Księga 38-1-33 z grodu kamienieckiego: 1197 stron rękopisu, 986 aktów.
A teraz pismo. Pisarze grodzcy pisali szybko, z mnóstwem skrótów, każdy po swojemu. „Ł” wygląda u nich jak „t”, długie „s” jak „f”, a wielkie „S” jak „Ł”. Atrament po trzystu latach bywa ledwie widoczny, a przez cienki papier przebija tekst z drugiej strony karty. Do tego języki: polszczyzna staropolska, łacina przeplatana z polskim w pół zdania, a w starszych księgach ruszczyzna kancelaryjna – czasem cyrylicą, czasem alfabetem łacińskim.
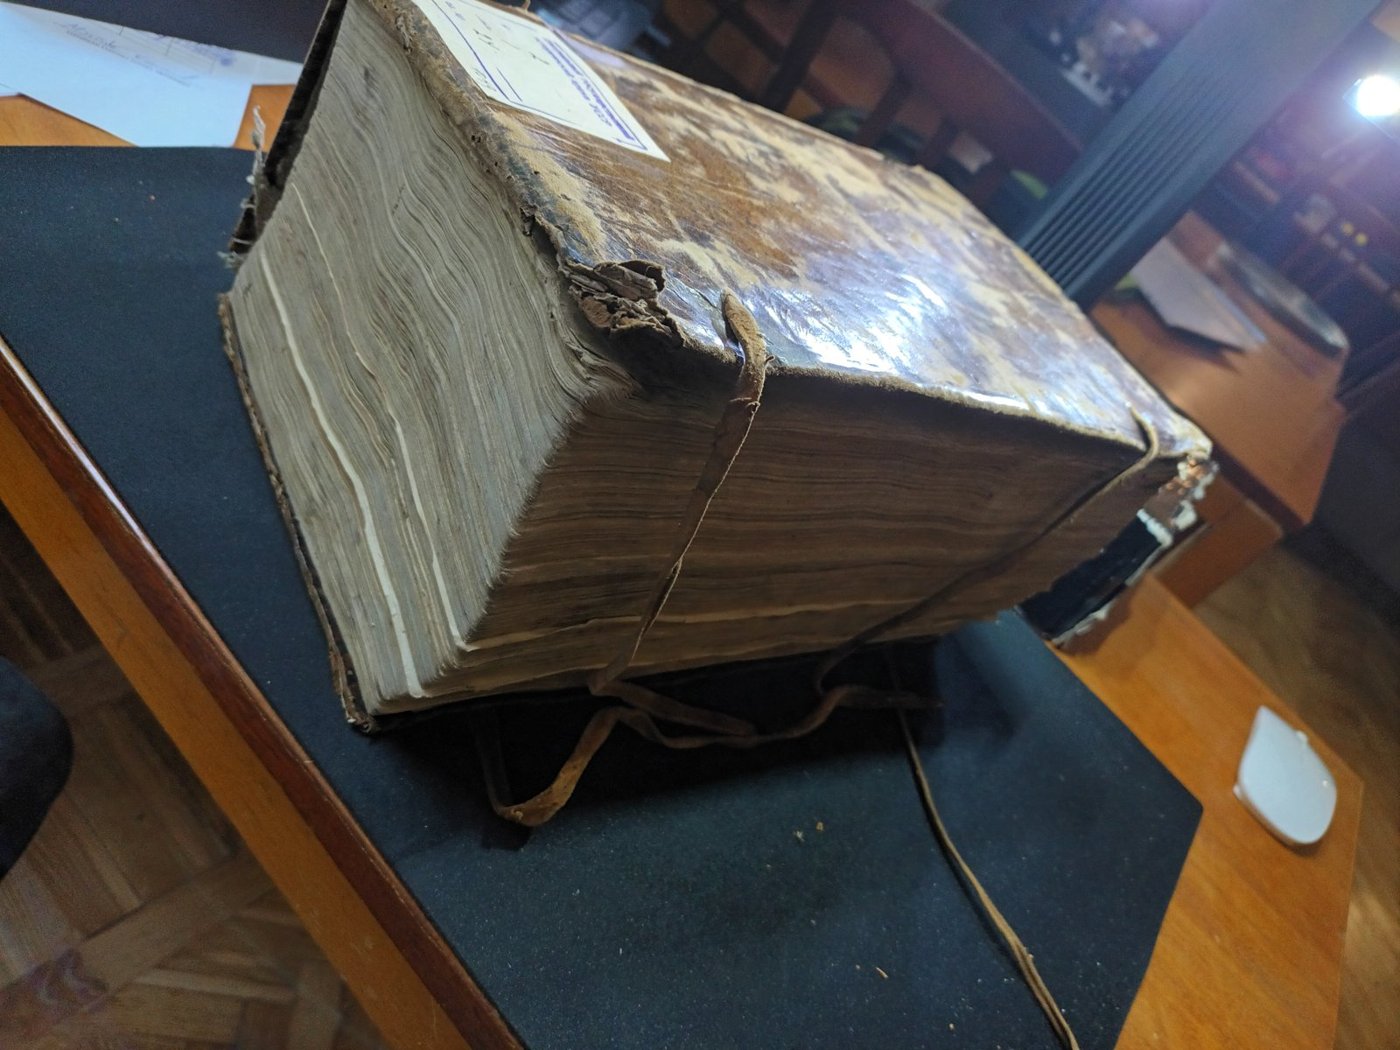
Niektóre księgi wyglądają tak, jakby przeszły wojnę. Bo często przeszły, i to niejedną.
Doświadczony paleograf przepisze dziennie może kilka, może kilkanaście stron takiego tekstu. Policzcie sami, ile lat zajęłaby jedna księga. A potem pomnóżcie przez liczbę ksiąg w archiwum. Właśnie dlatego większość z nich nigdy nie została przeczytana przez nikogo poza pisarzem, który je zapisał.
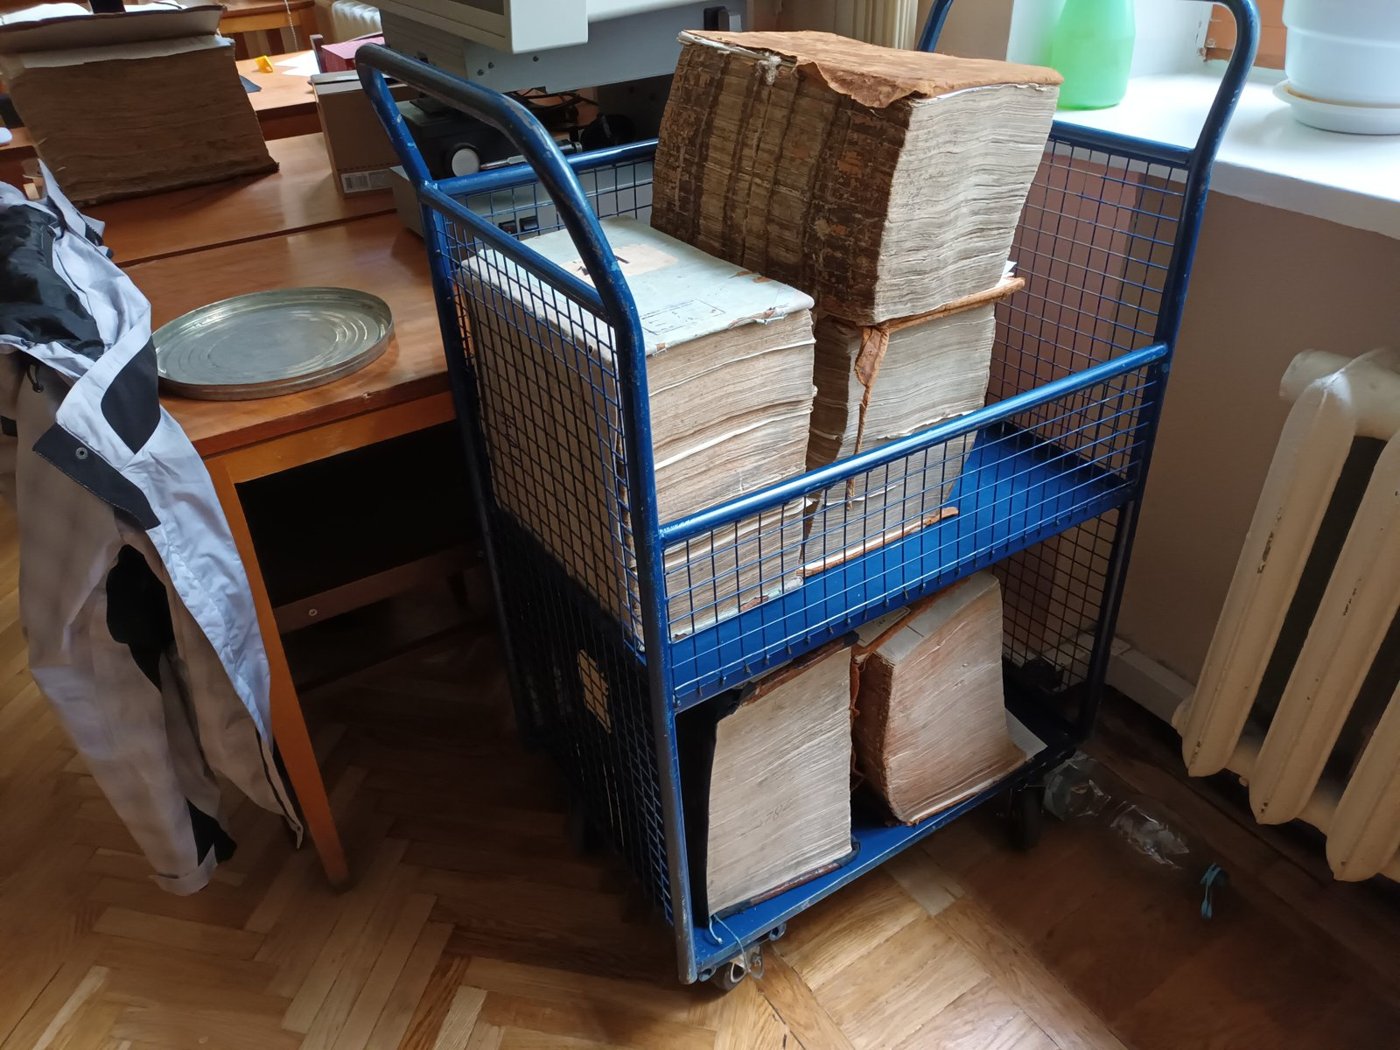
Jeden wózek ksiąg to kilka lat pracy dla człowieka. Albo kilka nocy dla automatu.
Pierwszy pomocnik: maszyna, która czyta
Na początku października 2026 roku zacząłem pracować z Claude’em, modelem sztucznej inteligencji firmy Anthropic. W najprostszych słowach: to program, któremu pokazuje się zdjęcie strony, a on odpisuje, co na niej jest napisane. Brzmi prosto, ale diabeł tkwi w szczegółach.
Całej rozkładówki naraz maszyna nie przeczyta dokładnie – litery są za drobne. Skan tnie się więc na poziome pasy po kilka wierszy, powiększa i podaje po kolei. Gdy atrament jest wyblakły, obraz przechodzi „pranie”: program odejmuje tło i podbija kontrast, aż tekst wyjdzie spod plam. Nazwiska ogląda się w jeszcze większym powiększeniu.
Z każdego aktu powstaje karta z ustalonymi częściami:
- Przepisany tekst, wiernie, linijka po linijce, ze skrótami jak w oryginale.
- Objaśnienia trudnych słów i tłumaczenie fragmentów łacińskich.
- Krótkie streszczenie po współczesnemu: kto, komu, co i za ile.
- Lista osób i miejscowości, z której później powstają indeksy.
Tam, gdzie maszyna nie jest pewna, stawia znak [?]. Tam, gdzie nic nie widać, stawia […]. To najważniejsza zasada całej roboty: lepiej przyznać się do niewiedzy, niż wymyślić nazwisko.
A błędy się zdarzają, i to bardzo podobne do błędów początkującego paleografa. Popławski wychodzi jako „Poptawski”, Hołubowski jako „Hotubowski”, Załuski jako „Zatuski” – bo pisarz kreślił „ł” dokładnie jak „t”. Najzabawniejszy przypadek: w jednym akcie maszyna odczytała niejakiego „Kazimierza Rembka [?]”. Kilkaset aktów dalej ten sam człowiek pojawił się zapisany wyraźniej i okazał się… Kasprem Szembekiem.
Tu wychodzi na jaw rzecz, którą zna każdy, kto czytał stare księgi: te same sprawy wracają. Ten sam woźny, ta sama wieś, ta sama formuła przysięgi pojawiają się w wielu aktach. Wystarczy je porównać, żeby rozstrzygnąć, co pisarz miał na myśli. Maszyna robi to w sekundy, przeszukując wszystko, co już przeczytała.
Próbowaliśmy tańszego, słabszego modelu. Mylił się tak często, że szybko zapadła decyzja: czyta wyłącznie najmocniejszy. Tańsza transkrypcja, którą trzeba poprawiać linijka po linijce, wcale nie jest tańsza.
Praca szła w trybie, który nazwaliśmy „sztafetą”. Co godzinę automatycznie startowała nowa sesja, odczytywała notatki poprzedniczki („zostałeś na akcie 455, skan 0473, uważaj, od tej karty zmienia się ręka pisarza”), przepisywała kilkadziesiąt aktów i przekazywała pałeczkę dalej. Cały dzień i całą noc. Ja w tym czasie spałem, jadłem i udawałem, że mam inne zajęcia.
Taśmociąg, czyli make.com
Sztafeta działała świetnie, ale jedna sesja to jeden „czytelnik”. Pod koniec października spróbowałem czegoś innego: zamiast rozmawiać z maszyną, zbudowałem jej taśmę produkcyjną. Służy do tego serwis make.com – coś w rodzaju klocków, z których układa się automat bez znajomości programowania.
Mój automat ma cztery klocki i robi dokładnie to, co robiłby bardzo cierpliwy praktykant:
- Zagląda do folderu na Dysku Google, w którym leżą zdjęcia stron.
- Pobiera stronę.
- Wysyła ją do Claude’a razem z instrukcją: jak czytać, co oznaczać, w jakiej formie oddać wynik.
- Odkłada gotowy tekst do drugiego folderu.
I tak co dwanaście minut, po trzydzieści stron naraz.
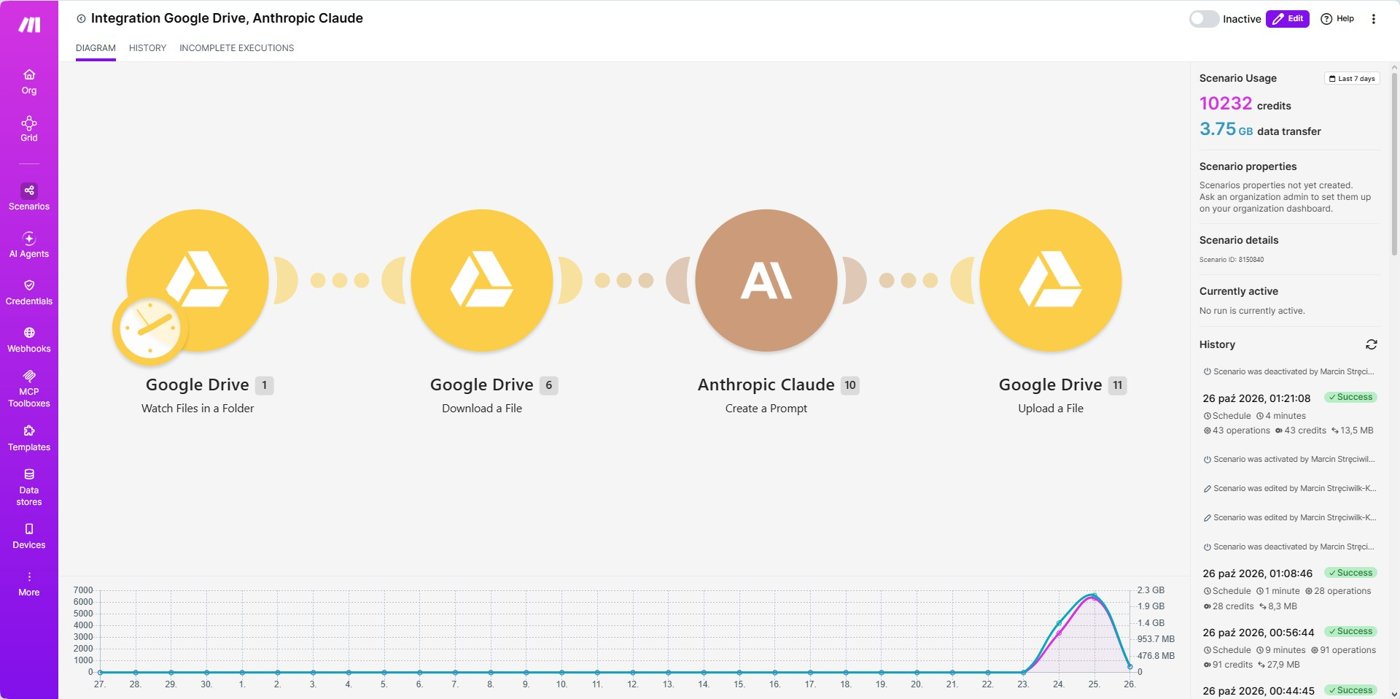
Cały „robot” na jednym ekranie. Po lewej zegarek: automat budzi się sam co 12 minut.
Najwięcej pracy kosztuje instrukcja dla maszyny. To kilka stron tekstu, który zaczyna się od słów „Jesteś doświadczonym paleografem i latynistą”. Dalej jest opis księgi, jej dat i miejsc, ostrzeżenia przed znanymi pułapkami („rok zapisano słownie jako Septingentesimo, ale nie przenoś go na inne wpisy”) i dokładny wzór, jak ma wyglądać wynik.
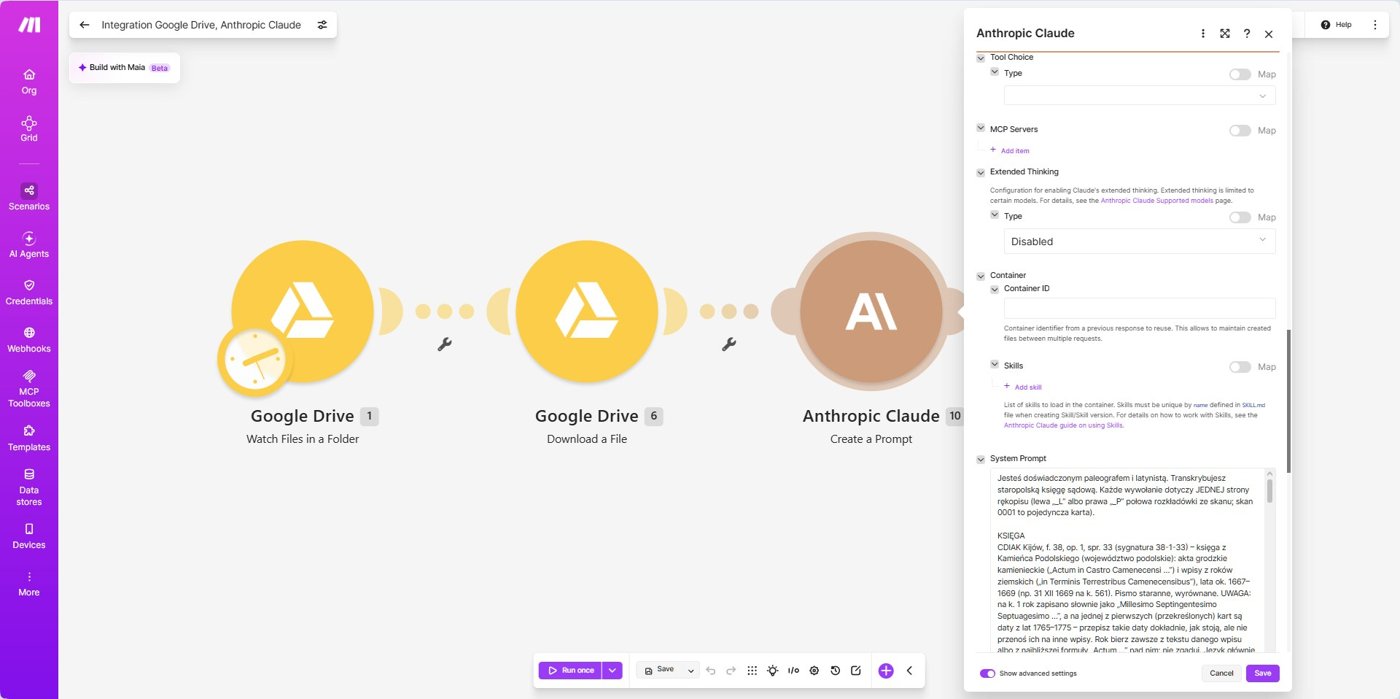
Instrukcja dla maszyny. Pisze się ją jak list do nowego współpracownika: kim jest, co ma zrobić i na co uważać.
Żeby automat miał co czytać, każdą rozkładówkę trzeba najpierw rozciąć na dwie osobne strony. Z 602 skanów księgi kamienieckiej zrobiło się w ten sposób 1197 stron. Robi to krótki program, nie nożyczki, choć porównanie jest trafne.
Noc z 25 na 26 października
Tak wyglądała typowa noc. Po południu wrzuciłem na Dysk 1197 stron księgi 38-1-33 z grodu kamienieckiego i włączyłem automat. Co kilkanaście minut w folderze wyników przybywało trzydzieści plików tekstowych.
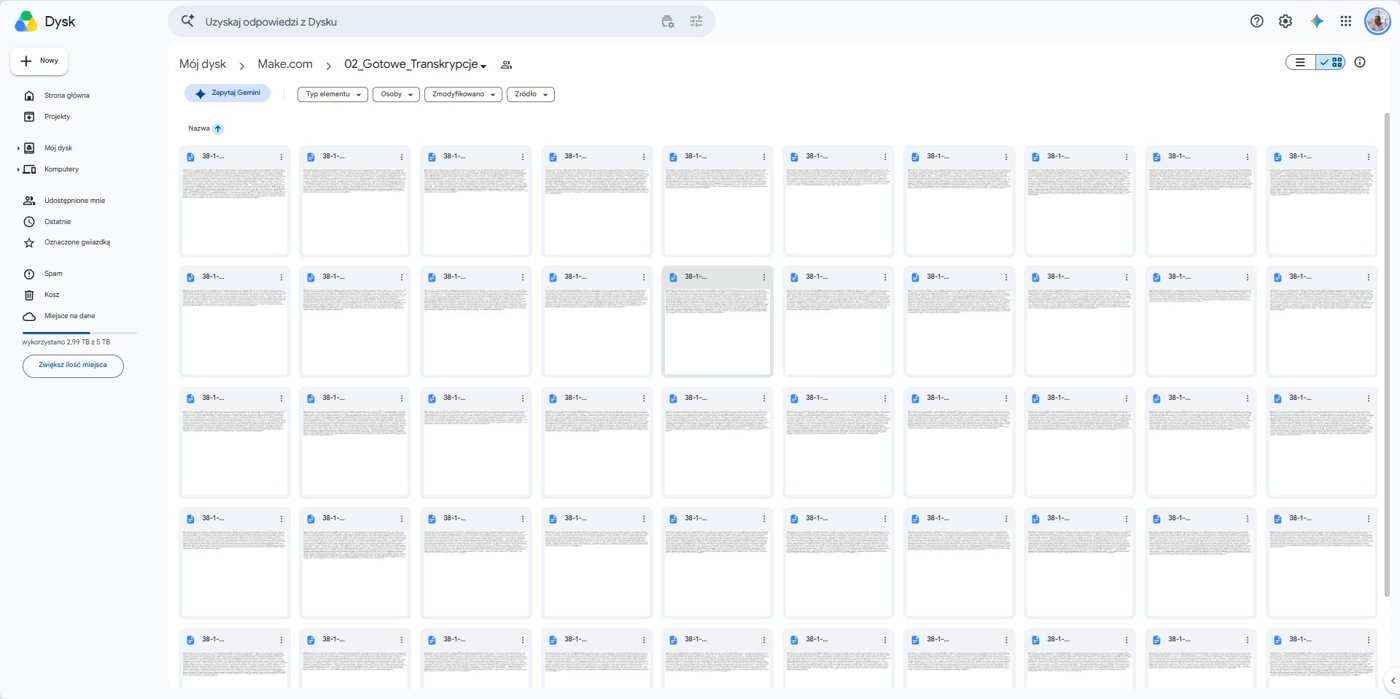
Folder wyników. Każdy kafelek to jedna strona rękopisu z 1667 roku, przepisana przez maszynę.
Moja rola? Mniej więcej co pół godziny ściągałem paczkę wyników na komputer i pisałem do Claude’a jedno słowo: „zip”. On rozpakowywał paczkę, sprawdzał, które strony są nowe, sklejał je w akty i odkładał na mój dysk. Ja patrzyłem i odpowiadałem na pytania.
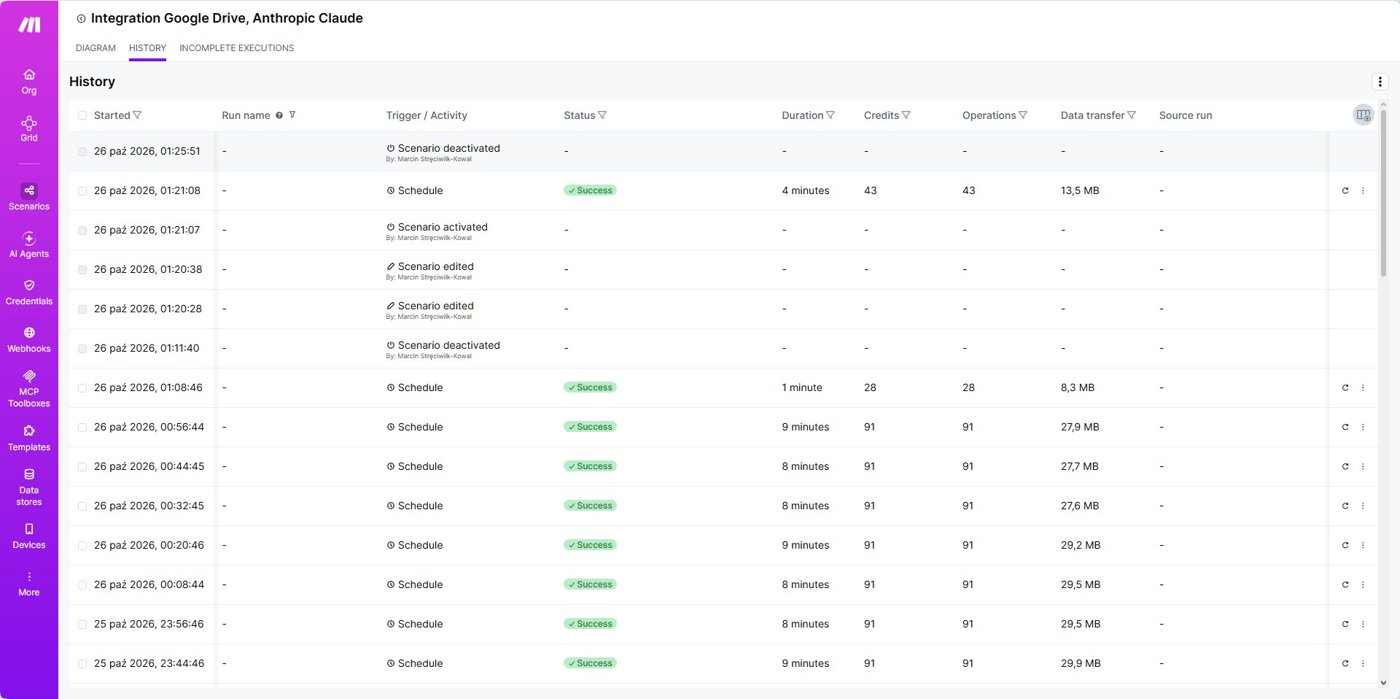
Historia pracy automatu: przebieg za przebiegiem, po 8–9 minut i 91 „kredytów” każdy. Na górze widać, jak wyłączam go o 1:25.
O 23:22 automat skończył pierwszy przebieg i… okazało się, że pominął 233 strony. Dysk Google nie nadąża z „zauważeniem” plików wgranych hurtem, więc część z nich robot po prostu przeoczył. Przygotowaliśmy osobny folder z brakującymi stronami i drugi przebieg. Potem trzeci, na ostatnie 14 stron. O 1:30 w nocy księga była przepisana w całości: 1197 stron, 986 aktów.
Na tym etapie trudno udawać, że to zwykłe hobby.
Z kartek w akty
Automat czyta stronę po stronie i o niczym więcej nie wie. Każda strona to dla niego osobny świat. Tymczasem pisarz grodzki nie przejmował się końcem kartki: akt zaczynał się na dole jednej strony, ciągnął przez trzy następne i kończył w połowie piątej.
Trzeba więc z kartek z powrotem złożyć akty. To zadanie dla osobnego programu, który nazwaliśmy po prostu „sklejaczem”. Wygląda to na drobiazg, ale w praktyce jest najtrudniejszą częścią całej roboty. Kilka przykładów z księgi kamienieckiej:
- Formuła „Actum in Castro Camenecensi…” z datą stoi na samym dole strony, a numer i treść aktu dopiero na następnej. Dla maszyny to dwa różne wpisy.
- Na marginesie archiwista ponumerował ołówkiem strony. Maszyna bierze tę liczbę za numer aktu i nagle w 1668 roku pojawia się akt nr 426, choć obok są akty 40 i 41.
- Pisarz numerował wpisy na marginesie, ale czasem ten sam numer dał dwa razy, a czasem jakiś pominął. W jednej księdze bywa kilka niezależnych serii numerów naraz: osobno dla Owrucza, osobno dla Żytomierza.
- Maszyna gubi pierwszą cyfrę (akt 150 staje się aktem 50) albo myli 8 z 7.
Na każdą taką pułapkę sklejacz dostaje nową regułę. Tam, gdzie reguły nie wystarczają, wpisuje się poprawkę ręcznie. Dla księgi kamienieckiej takich poprawek jest 234.
I tu wraca człowiek. Gdy numery nie pasują do sąsiadów, a z samego tekstu nie da się rozstrzygnąć, Claude pyta. Wygląda to mniej więcej tak:
Claude: Na stronie 465L są dwa akty. Odczyt modelu: „119” i „219”. Sąsiednie akty to 118 i 121. Możesz sprawdzić na skanie?
Ja: 465L – 119, 120.
Otwieram skan, patrzę na margines i odpisuję w kilka sekund. Maszyna nie zgaduje, ja nie przepisuję tysiąca stron. Uczciwy podział pracy.
Rachunek
Zawsze pada to pytanie, więc odpowiadam od razu: strona rękopisu przepisana przez automat kosztuje mnie około 7 centów, czyli mniej więcej 30 groszy. Cała księga na tysiąc dwieście stron to koszt dobrego obiadu w restauracji dla dwóch osób.
Płacę dwa rachunki. Pierwszy firmie Anthropic za pracę modelu, liczoną w „tokenach”, czyli kawałkach tekstu i obrazu. Drugi serwisowi make.com za ruchy automatu, liczone w „kredytach”.
| Co | Koszt | Uwagi |
|---|---|---|
| Księga 2-1-2 (Żytomierz, Owrucz) | 131,88 $ | 1884 strony; z kredytu promocyjnego 200 $ |
| Księga 38-1-33 (Kamieniec) | ok. 84 $ | 1197 stron, razem z powtórkami |
| Średnio za stronę (model) | ok. 0,07 $ | ok. 30 gr |
| make.com | ok. 3 kredyty za stronę | dokupione 1000 kredytów kosztowało 1,33 $ |
Kwoty w złotówkach są przybliżone, bo zależą od kursu dolara. Sesje „sztafety”, w których Claude czytał skany bezpośrednio w rozmowie, mieszczą się w miesięcznym abonamencie, więc nie da się ich łatwo przeliczyć na strony.
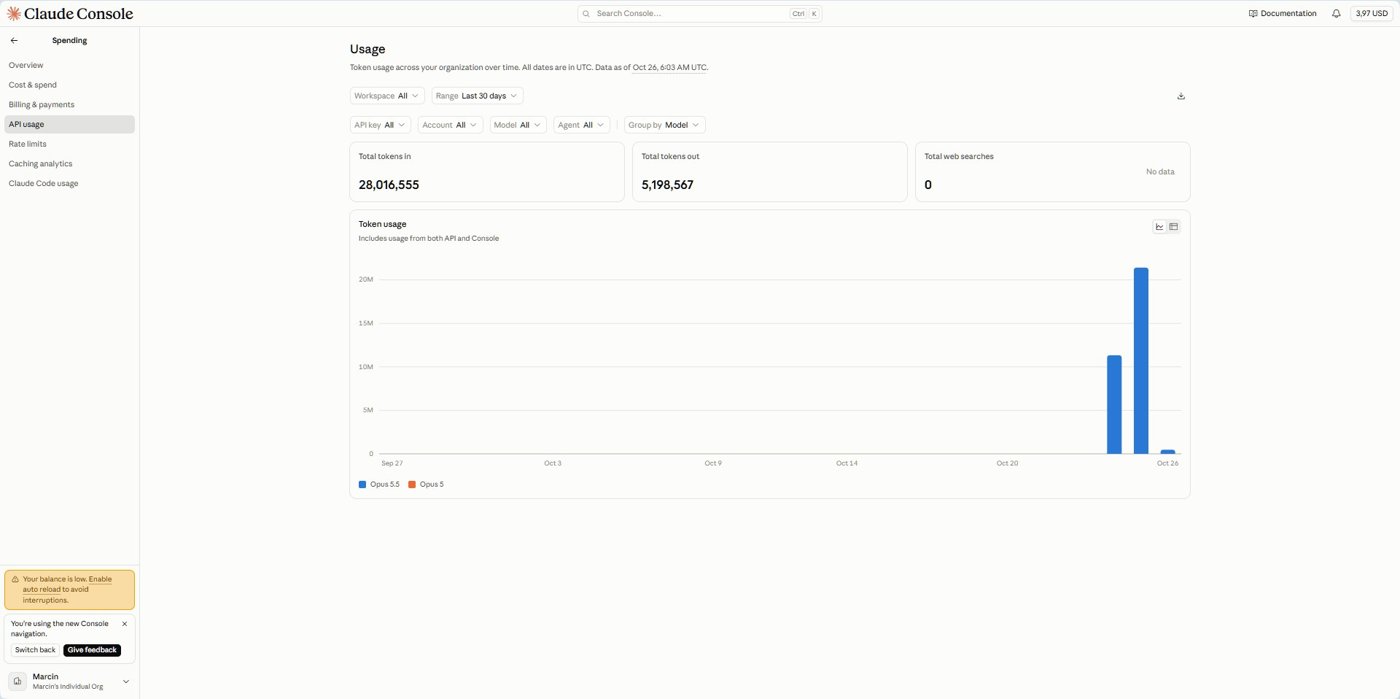
W ciągu trzech dni maszyna „zjadła” 28 milionów tokenów na wejściu i oddała 5 milionów na wyjściu. Token to mniej więcej kawałek słowa, więc to biblioteczka sporych rozmiarów.
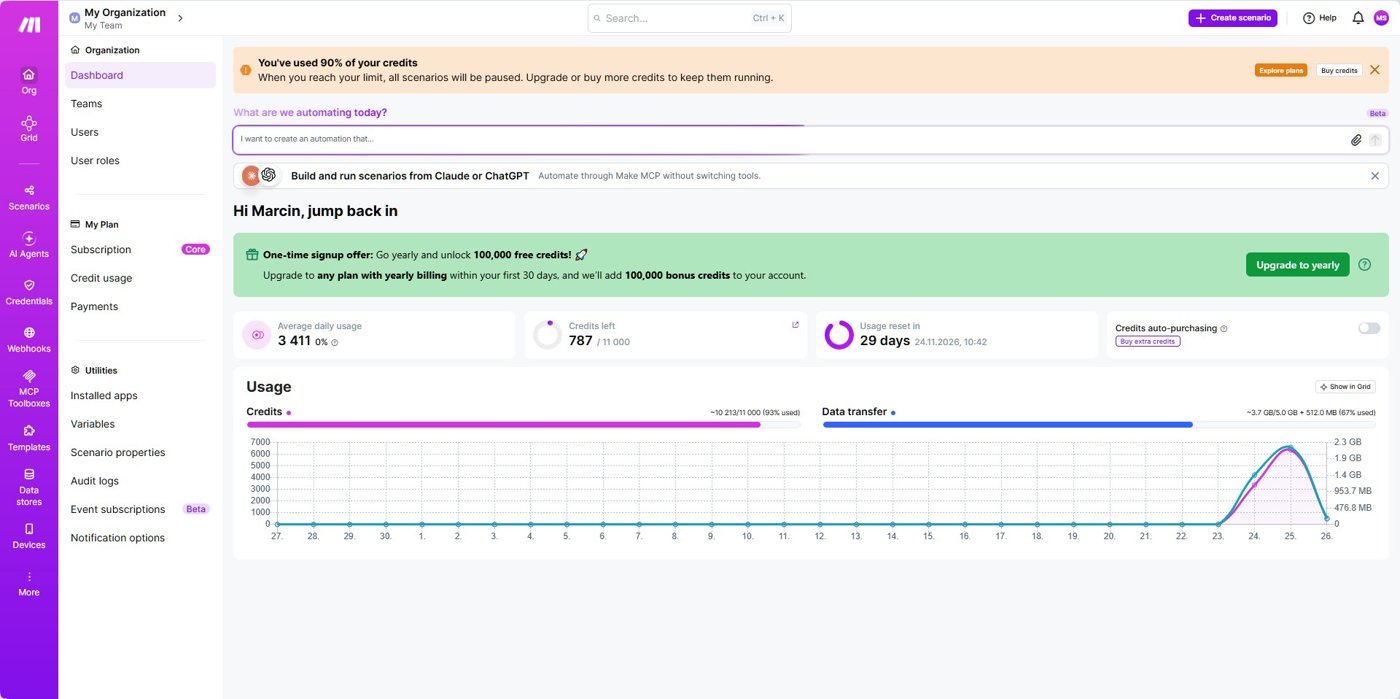
A tak wygląda mój miesięczny limit w make.com po dwóch nocach pracy: 93 procent wykorzystane. Stąd dokupione kredyty.
Czy to dużo? Nie odważę się liczyć, ile wziąłby zawodowy paleograf za tysiąc dwieście stron i ile lat by to trwało. Zresztą to porównanie jest nieuczciwe w obie strony. Paleograf nie pomyli Szembeka z Rembkiem. Maszyna nie zmęczy się po trzeciej stronie i nie poprosi o urlop.
Wpadki i niespodzianki
Gdyby ktoś myślał, że wszystko idzie gładko jak w reklamie, kilka scen z ostatnich tygodni.
Zip o pierwszej w nocy. Paczki wyników nazywają się tak samo, różnią się tylko datą i godziną. Którejś nocy, już mocno po północy, ściągnąłem z Dysku nie ten folder: zamiast czternastu gotowych transkrypcji wysłałem Claude’owi czternaście zdjęć stron do przepisania. Odpowiedź była uprzejma, ale stanowcza: to nie są wyniki, to są kartki, które dopiero trzeba przeczytać.
Robot, który nie widzi. Automat co jakiś czas „gubił” strony. Wyglądało to tajemniczo: przebiegi bez błędów, a w wynikach dziury. Winowajcą okazał się Dysk Google, który setki plików wgranych naraz „zauważa” z opóźnieniem. Lekarstwo: odczekać kwadrans po wgraniu, a brakujące strony zebrać do osobnego folderu i puścić jeszcze raz.
Kredyty na wyczerpaniu. W środku nocy make.com poinformował, że wykorzystałem 90 procent miesięcznego limitu. Szybki zakup, 1,33 dolara, jedziemy dalej. Najtańszy zakup w historii mojej genealogii.
„Siedmset” zamiast „Sześćset”. W jednym z aktów maszyna odczytała rok jako tysiąc siedemset dziewięćdziesiąty siódmy. Na skanie stoi wyraźnie: „Tysiąc Sześćset Dziewięćdziesiąt Siódmego”. Sto lat różnicy przez jedno słowo. Od tej pory lata zapisane słownie sprawdzamy na skanie zawsze.
Józef Kalasanty w 1699 roku. Księga 2-1-1 zawiera odpisy rzekomo XVII-wiecznych aktów. Czytając je, maszyna zaczęła zgłaszać dziwne rzeczy: świadek o imieniu Józef Kalasanty (święty kanonizowany dopiero w 1767 roku), porucznik „Kawaleryi Narodowey” (formacja z drugiej połowy XVIII wieku), dokument „na papierze ceny grosza srebrnego”. Wyglądało to na późne fałszerstwa – i rzeczywiście, o tym za chwilę.
Falsyfikat droższy od oryginału. Przy księdze kamienieckiej miałem wrażenie, że trzymam w rękach fałszywkę, i to konkretną. Rok na pierwszej karcie zapisano słownie jako tysiąc siedemset siedemdziesiąty któryś, choć treść dotyczy lat 1667–1669. Zastanawiałem się chwilę, czy przerwać. Postanowiłem: przepisujemy do końca. Dobrze udokumentowany falsyfikat bywa dla historyka cenniejszy niż oryginał, bo mówi, kto, kiedy i po co chciał sobie dopisać przodków.
Prawie 903 pliki. Raz sklejacz, uruchomiony w brudnym katalogu, chciał wgrać na mój dysk 903 pliki zamiast 108. Claude zauważył to przed zapisem, wyczyścił katalog i zrobił wszystko jeszcze raz. Od tej pory w instrukcji jest zdanie wielkimi literami: najpierw posprzątaj.
Człowiek nadal potrzebny
Obiecana historia o fałszerstwach. Kiedy skończyliśmy księgę 2-1-1, pokazałem ją znajomemu, Olegowi, który zna tę epokę jak mało kto. Jego werdykt był krótki: to w większości XIX-wieczne fabrykaty. Takie „odpisy dawnych aktów” wyrabiano masowo, żeby przed heroldią udowodnić szlachectwo. Autentycznych jest w księdze niewiele.
Maszyna sama tego nie powiedziała. Zauważyła dziwne imiona, anachroniczne urzędy i podejrzane daty, wszystko starannie opisała w uwagach. Ale złożyć to w jeden obraz i nazwać rzecz po imieniu potrafił dopiero człowiek, który całe życie czyta takie dokumenty. Teraz każdy plik z księgi 2-1-1 zaczyna się od noty o źródle, która o tym uprzedza.
Ten sam ekspert poprawił mnie w sprawach, których żaden program by nie wychwycił. „Donacja” w XVII-wiecznym akcie to często zwykła sprzedaż, przebrana w starą formułę prawniczą. Złoty był jednostką obrachunkową, a płacono różnymi monetami, co zajmowało mnóstwo czasu. Takie rzeczy wie się z lektury tysięcy aktów, a nie z przeczytania jednego.
Dlatego w całym tym przedsięwzięciu są trzy role, i żadnej nie da się skreślić:
- Maszyna czyta, przepisuje, porównuje, liczy i zgłasza wątpliwości.
- Ja sprawdzam na skanie to, czego maszyna nie jest pewna, decyduję, co robimy dalej, i pilnuję, żeby wszystko trafiło na właściwe miejsce.
- Ekspert ocenia, czym w ogóle jest dana księga i jak rozumieć jej treść.
Sztuczna inteligencja niczego tu nie zastępuje. Zabiera tylko tę część pracy, której i tak nikt by nigdy nie wykonał.
Co z tego ma genealog
Wszystko to nie jest sztuką dla sztuki. Od początku października powstały transkrypcje dwunastu ksiąg z Winnicy, Latyczowa, Kijowa i Kamieńca: około 6300 aktów. Przeczytanie ich w tradycyjny sposób zajęłoby całe życie.
Gotowe księgi trafiają do serwisu Staropolskie Księgi Sądowe na mojej stronie. Co tam znajdziecie:
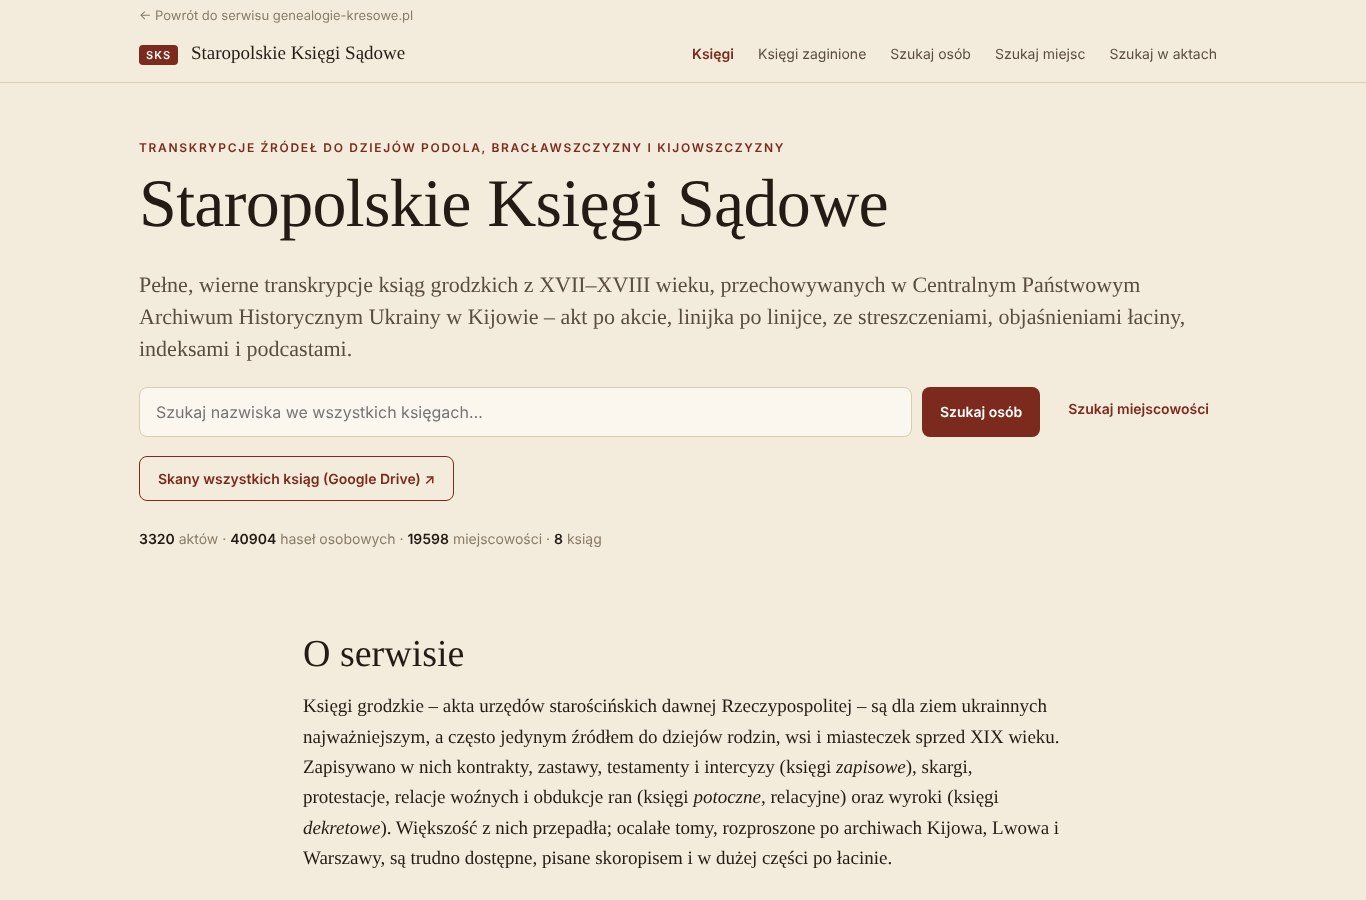
Strona główna serwisu. Na dole licznik: 3320 aktów, 40 904 haseł osobowych i 19 598 miejscowości z ośmiu ksiąg – a kolejne czekają w kolejce.
- Treść aktów: przepisany tekst, objaśnienia, tłumaczenia łaciny i streszczenie każdego aktu po współczesnemu.
- Wspólną wyszukiwarkę osób dla wszystkich ksiąg naraz: wpisujecie nazwisko i od razu widzicie, w których aktach się pojawia.
- Wspólną wyszukiwarkę miejscowości, także z dawnymi formami nazw, zapisanymi tak jak w rękopisie.
- Podcasty do kolejnych części ksiąg, przygotowane z pomocą innego modelu sztucznej inteligencji, Gemini firmy Google. Każdy ma uczciwą adnotację, że powstał z pomocą AI i może zawierać błędy.
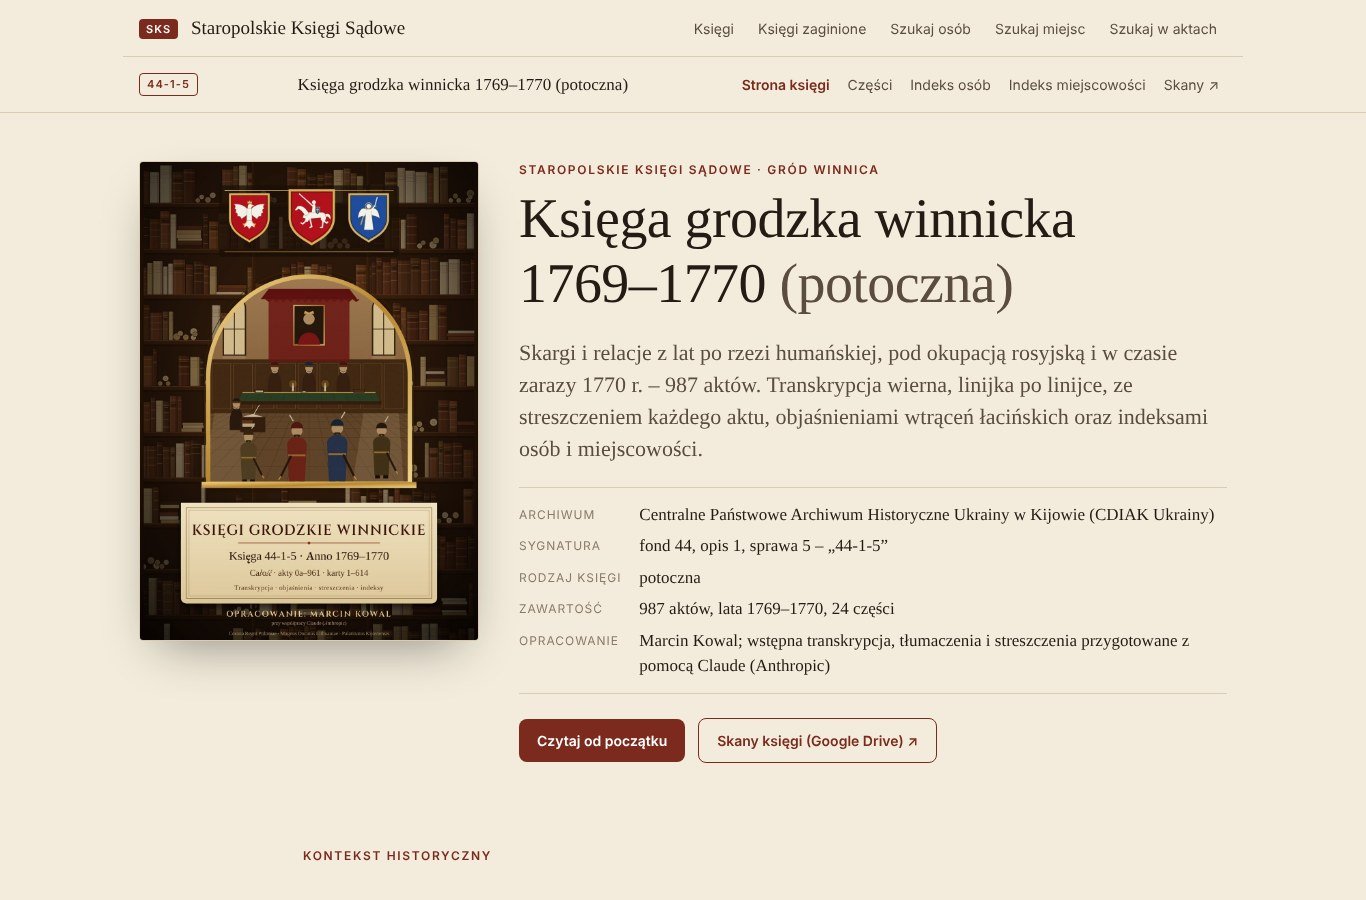
Każda księga ma własną stronę: opis, sygnaturę, zawartość, odnośnik do skanów i przycisk „Czytaj od początku”.
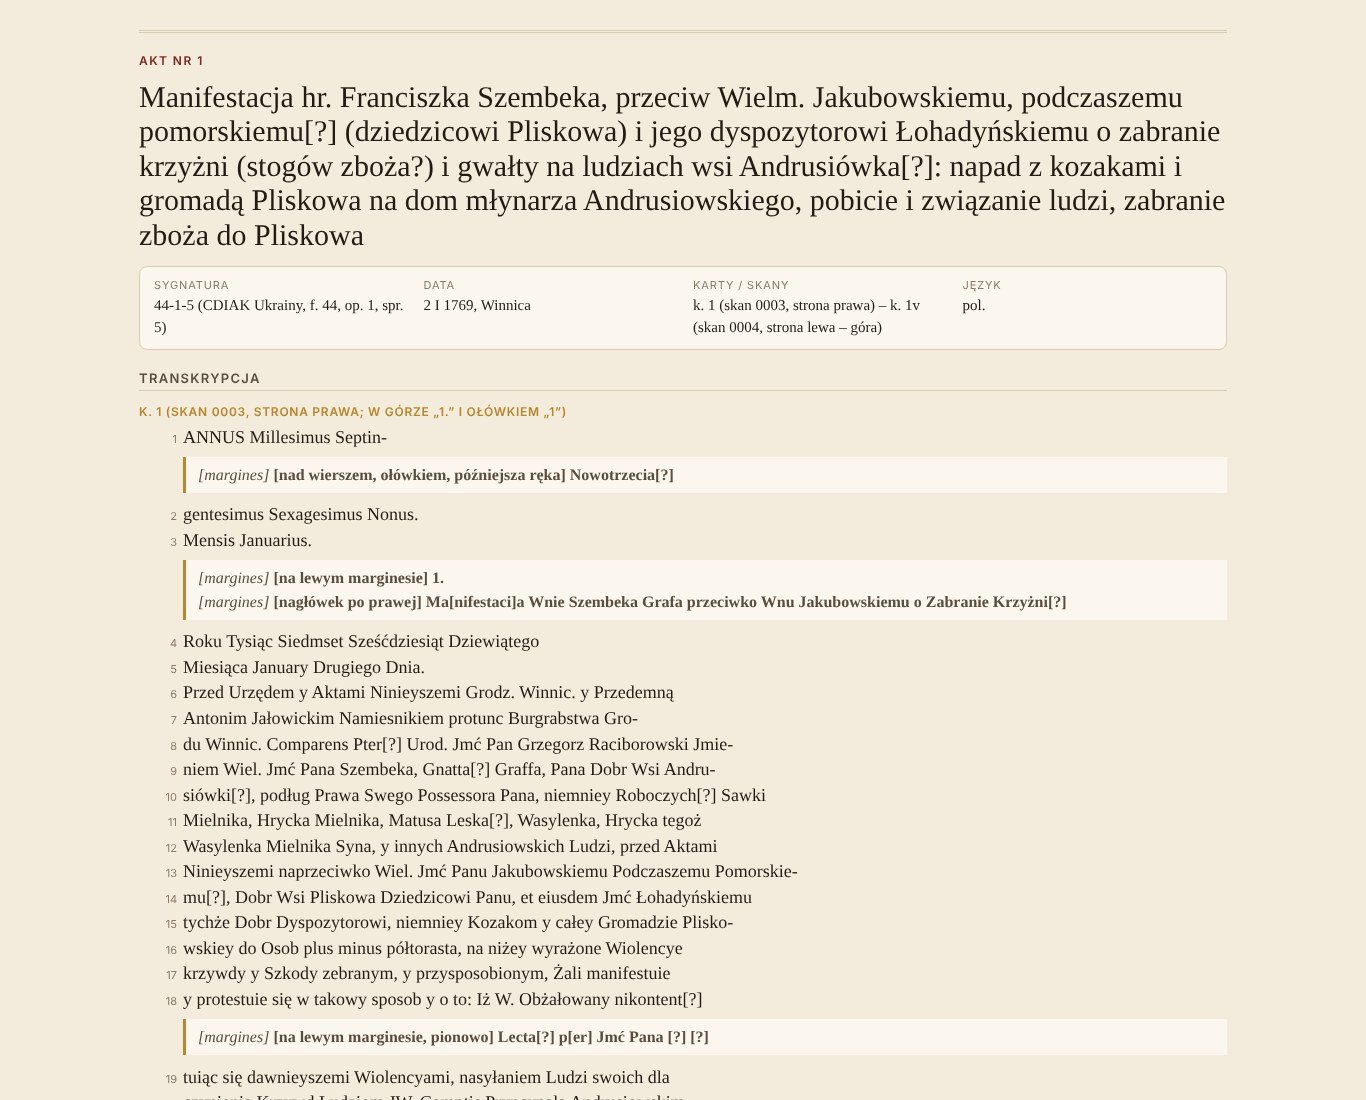
Tak wygląda gotowy akt: tytuł po współczesnemu, metryczka (sygnatura, data, karta, język) i tekst wiersz po wierszu, z dopiskami z marginesu. Pod spodem są jeszcze objaśnienia i streszczenie.
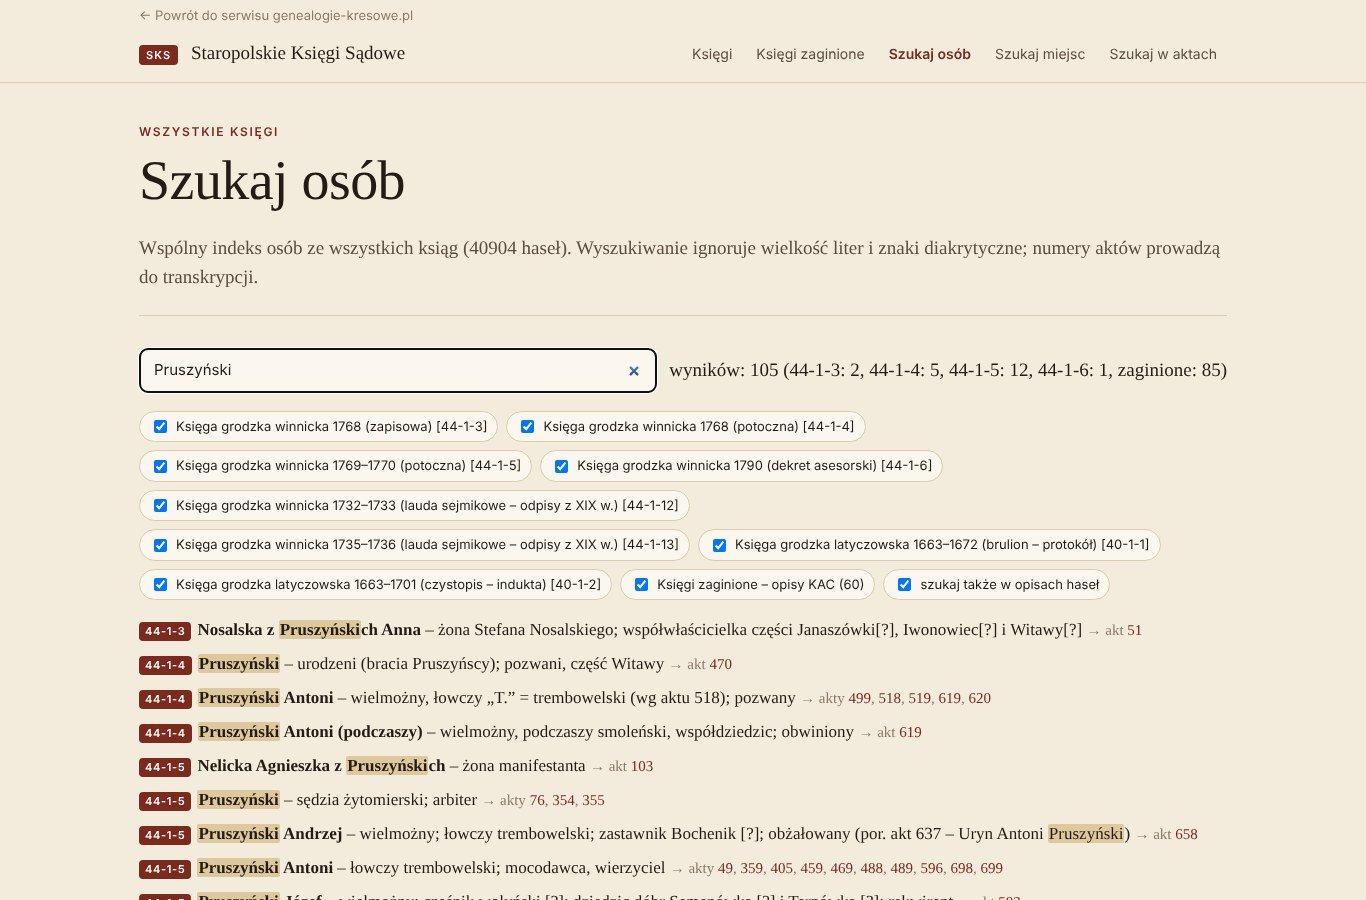
Wyszukiwarka osób. Wpisałem „Pruszyński” i dostałem 105 wyników z kilku ksiąg, z numerami aktów, które prowadzą prosto do tekstu.
W serwisie są już księgi winnickie i latyczowskie. Księgi kijowskie i kamieniecka będą dochodzić po kolei, gdy przejdą redakcję.
Jeśli Wasi przodkowie mieli cokolwiek wspólnego ze szlachtą Podola, Bracławszczyzny czy Kijowszczyzny w XVII i XVIII wieku, jest spora szansa, że któryś z nich coś kupił, sprzedał, zapisał żonie albo pokłócił się z sąsiadem. I że ten wpis właśnie da się znaleźć jednym wyszukaniem.
To jak, czy to jeszcze genealogia?
Przyznaję, że zadawałem sobie to pytanie o drugiej w nocy, patrząc na licznik kredytów, historię przebiegów automatu i kolejną paczkę z setką plików tekstowych. Genealogia kojarzyła mi się kiedyś z ciszą czytelni, z lupą i z zapachem starego papieru. Teraz kojarzy się także ze słowem „zip”.
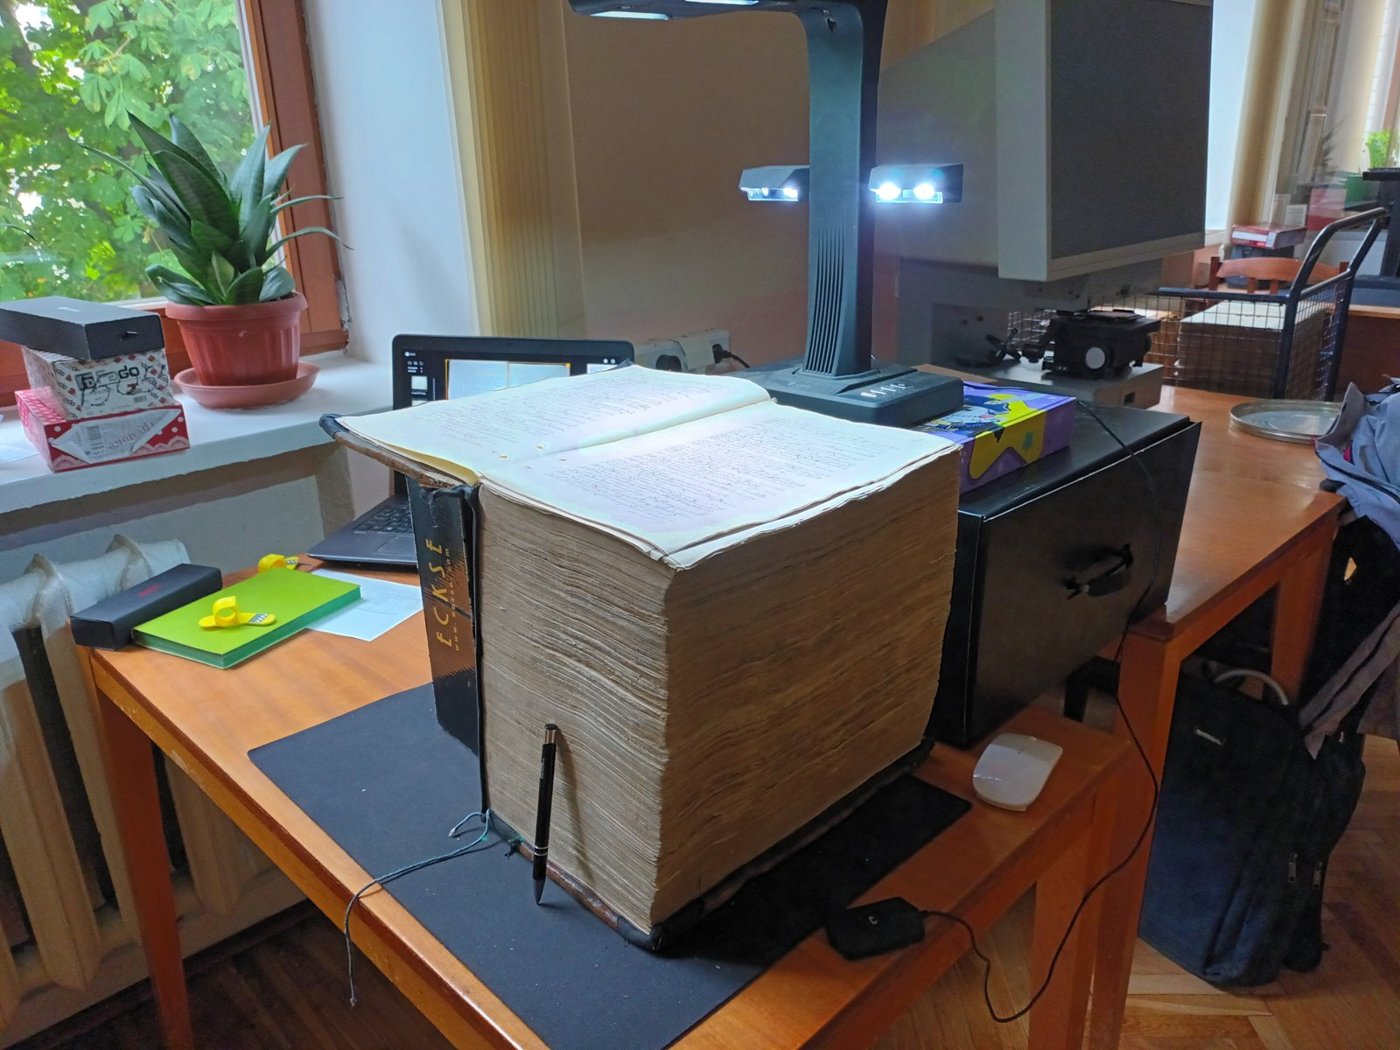
Tu wszystko się zaczyna: stara księga, okno, skaner. Reszta dzieje się już w chmurze.
Ale kiedy rano otwieram gotowy akt i czytam, że w 1668 roku jakiś szlachcic w Kamieńcu kwitował sąsiada z długu albo zapisywał żonie dwie wsie w dożywocie, to wiem, że robię dokładnie to samo, co robiłem na początku. Szukam ludzi. Zmieniły się tylko narzędzia, no i skala.
Nasi poprzednicy przepisywali akta ręcznie, potem robili fiszki, potem bazy danych w komputerze. Każde pokolenie genealogów miało swoje „czy to jeszcze genealogia?”. Moje pokolenie ma roboty, które czytają po łacinie i nie narzekają na pismo pisarza grodzkiego.
Więc tak: to jest genealogia. Tylko z bardzo dużą ilością kawy i bardzo pracowitym pomocnikiem, który nigdy nie śpi.
Marcin Kowal, genealogie-kresowe.pl
Artykuł powstał we współpracy z Claude’em (Anthropic) – tym samym, który przepisuje księgi. Napisał pierwszą wersję, ja poprawiłem i podpisuję się pod każdym słowem.